线性注意力
传统attention是O(n^2)复杂度
flashAttention用分块和重算减少了显存IO,但是理论复杂度还是O(n^2)
gpu算除法可能比较慢
qkv
cuda模型
thread warp block sm grod
1 个warp是32个thread 执行相同命令
block也叫cta 协助线程组 线程合作的范围
SM可以塞64个wrap 同时跑4个
每个block都是独立执行的程序,block之间没有数据依赖,block可以按任意顺序调度到sm上 不关心有几个sm 不用编译和修改点
- 自动可扩展性
ptx是高级汇编(parallel thread execution)
cubin 是gpu可执行文件
CC 7.0 这个是Compute Cability
Local内存可能在hbm上
最快的是reg
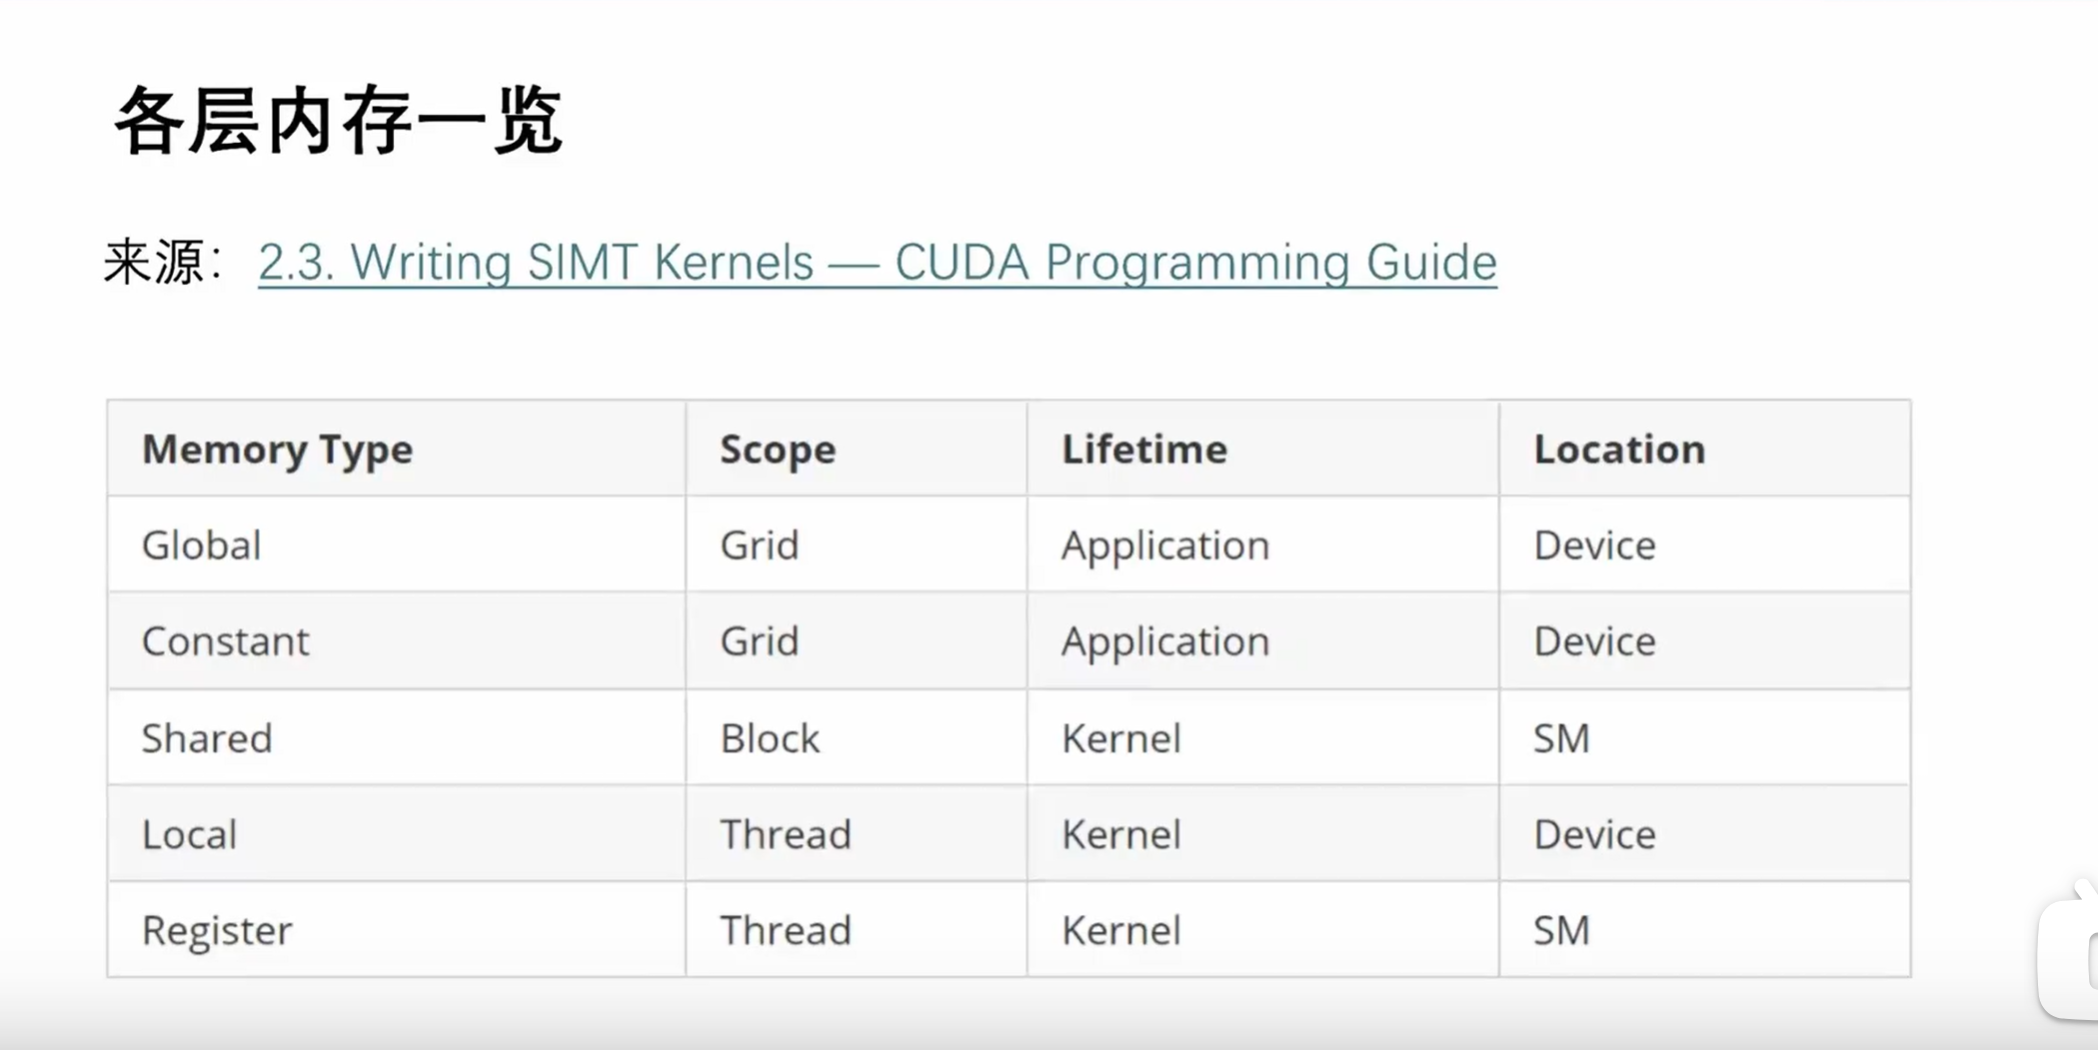
shared_mem 是L1 cache的一部分
**__restrict__ 关键词表示这个指针和别的没有重叠**
一个sm 4个1分区,每个分区32个cuda core和1个tensor core
除法有快速倒数路线 但是有误差 会根据牛顿迭代减少误差
cuda 的寄存器很多 和cpu的l1 寄存器一样多
warp调度屏蔽延迟
活跃的wrap越多有助于隐藏延迟
Occupancy = 实际活动 warp 数 / 最大支持 warp 数 高 occupancy 有助于隐藏延迟。
但是高Occupancy 可能导致寄存器不够用
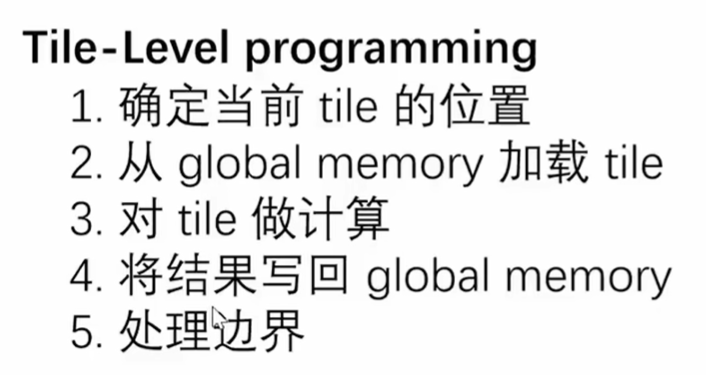
tile level programing
DSL
- sql也是一个数据库的dsl
- 正则表达式也算是dsl
triton局限性
- shared memory布局 bank conflict全靠编译器
- 生产的ptx sass不透明 性能难定位
- 性能天花板 具体cutlass 和cublass 有差异
- 复杂pipeline warp specialization难表达
- 复杂kernel别扭
- 报错性能回退难分析 依赖反复autotune
- 用控制权提高了开发效率
- tilelang是更底层的工具?
triton更接近张量表达式
tilelang更解决手写cudakernel
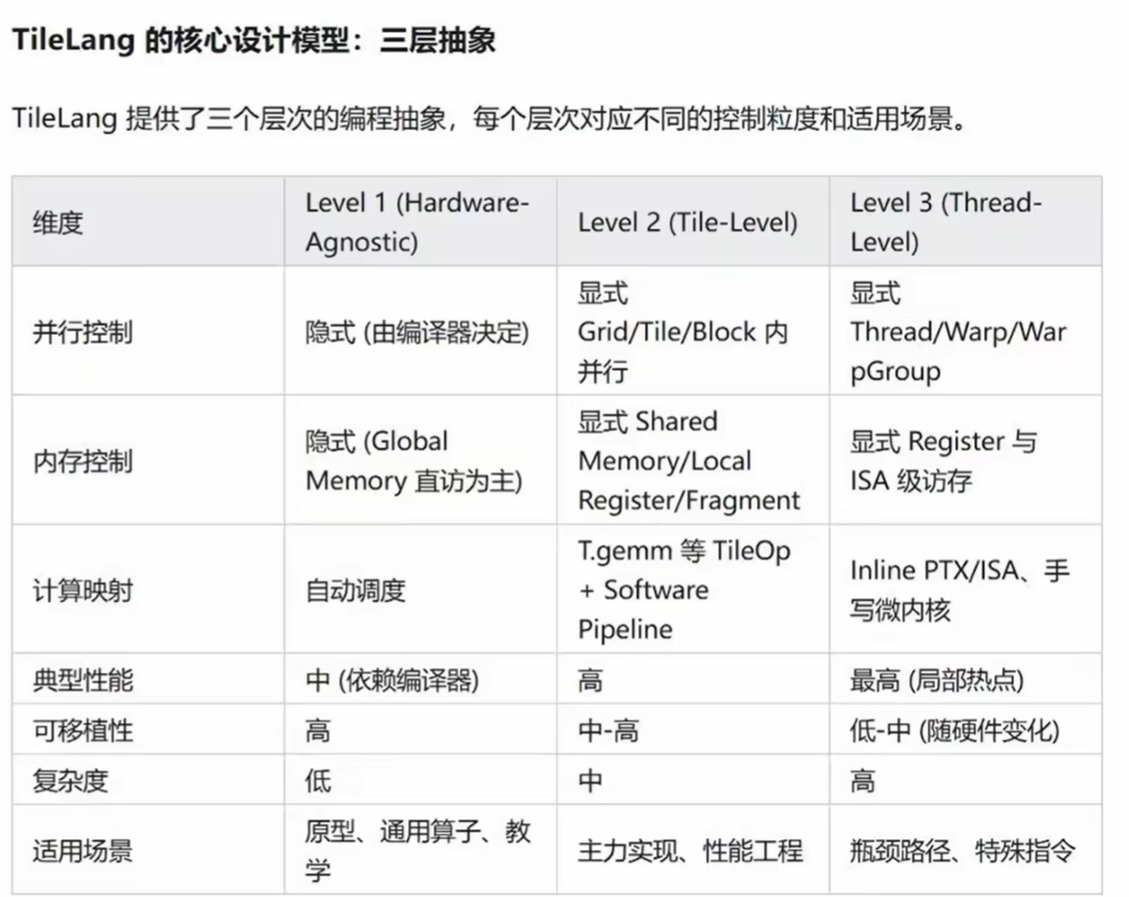
triton
- 快速写出简洁kernel
- 适合elementwise reduction matmul attention
tilelang
- 显式表达内存层次和数据复用
- 适合高性能kernel
- 对于内存瓶颈 可能足够优化了
cuda
- 控制力度细
- 极端性能调优和特殊硬件适配(泛化能力就差一些 对于不同硬件)
最大性能取决于内存带宽和计算性能中比较小的那个
tensorcode 脉冲阵列用于矩阵乘
gemm
vllm变成了一个生态
- 各类模型厂商
- pytorch
vllm是交接点
- 开源模型
- 硬件厂商
现在的推理框架类似OS 内核
- 框架是如何管理复杂度的问题
- 不同模型
- 不同硬件
- 不同模型代码 不同算子类似于driver
PD+heterogeneous(异质的) TP 这样场景会有问题 pd的tp不一样没法直接传递
guided decoding 有目标的去decoding(json格式)